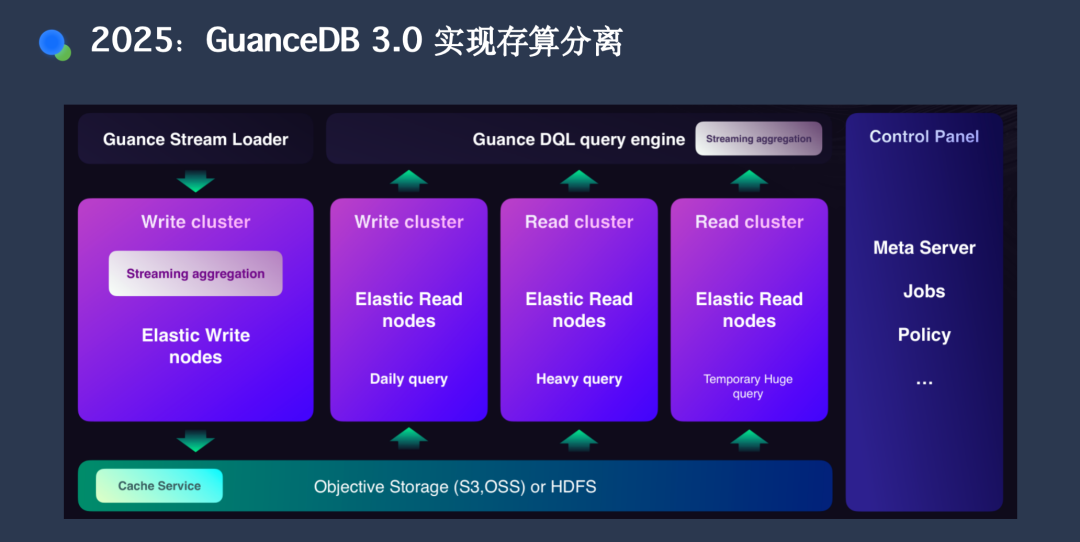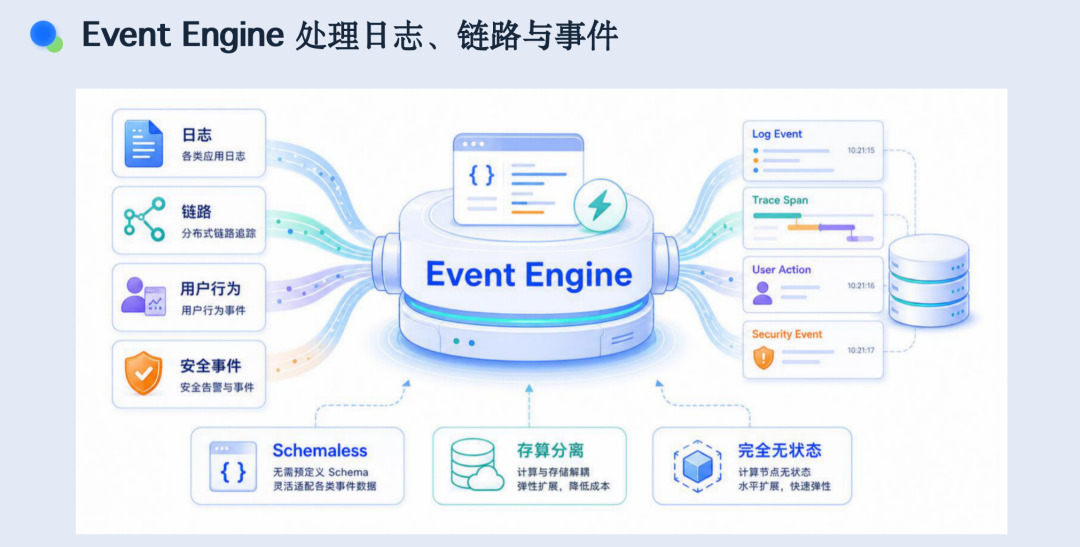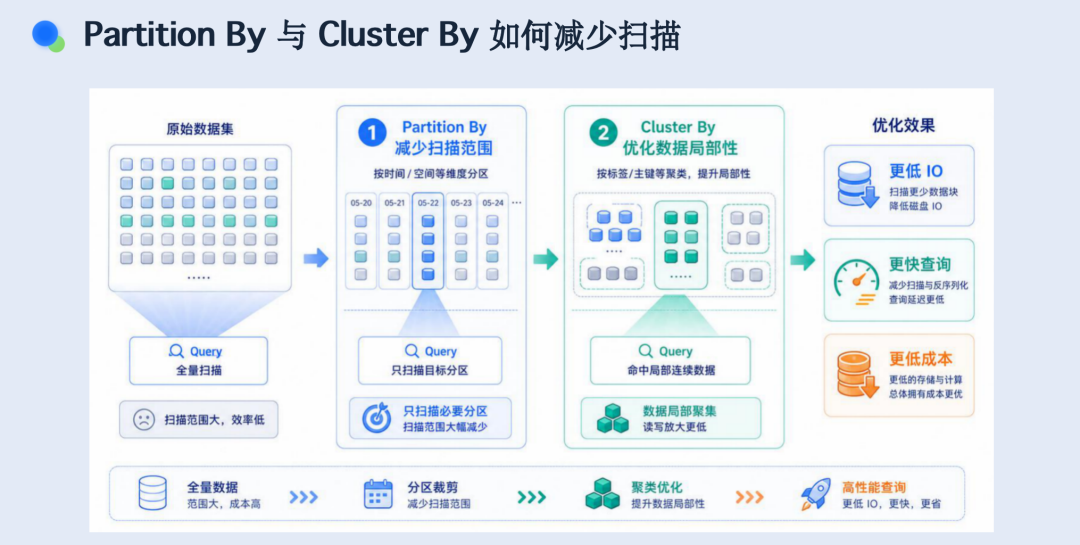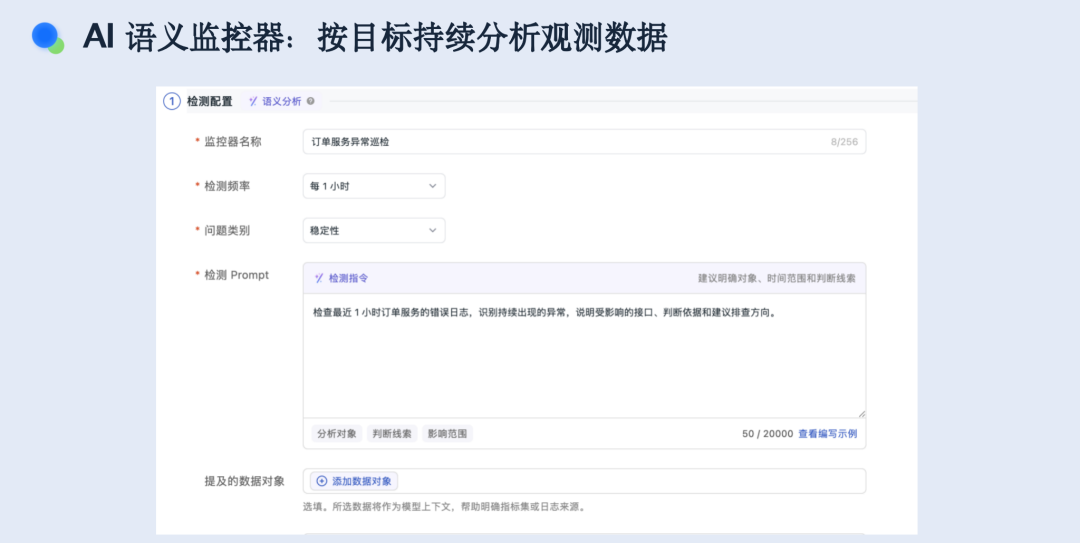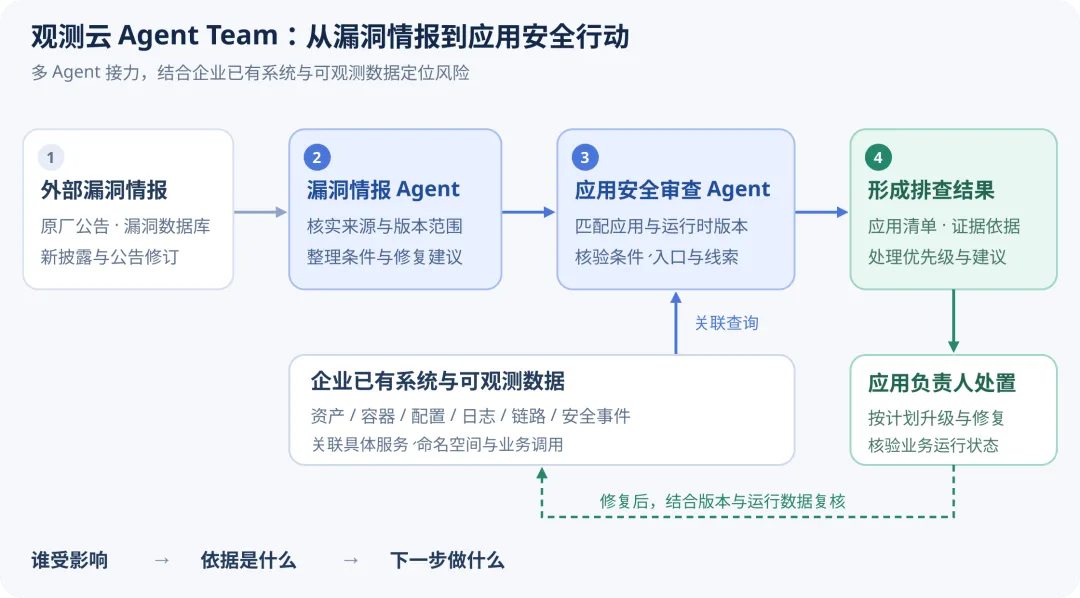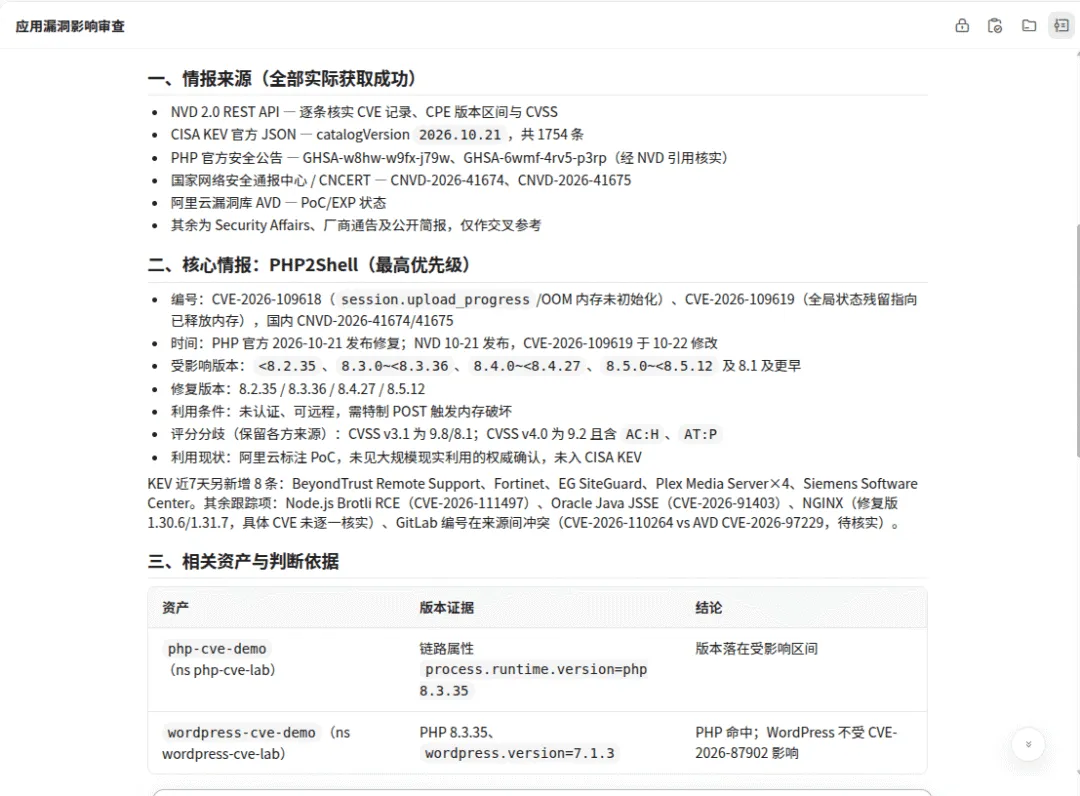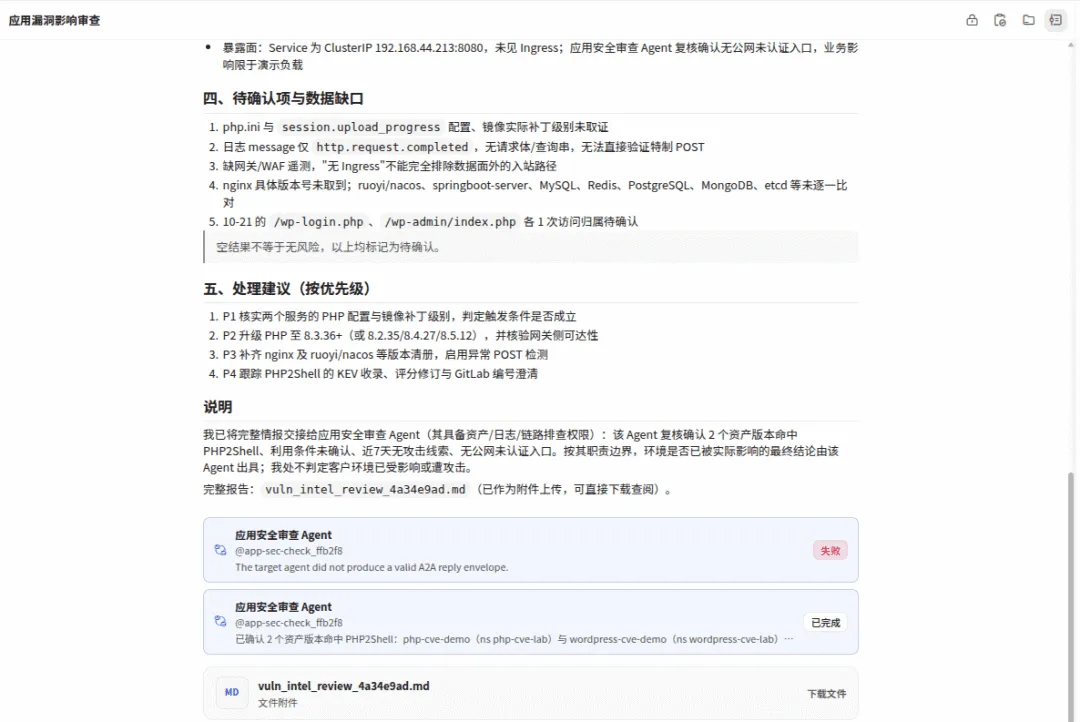
从分散的监控数据到完整的问题现场
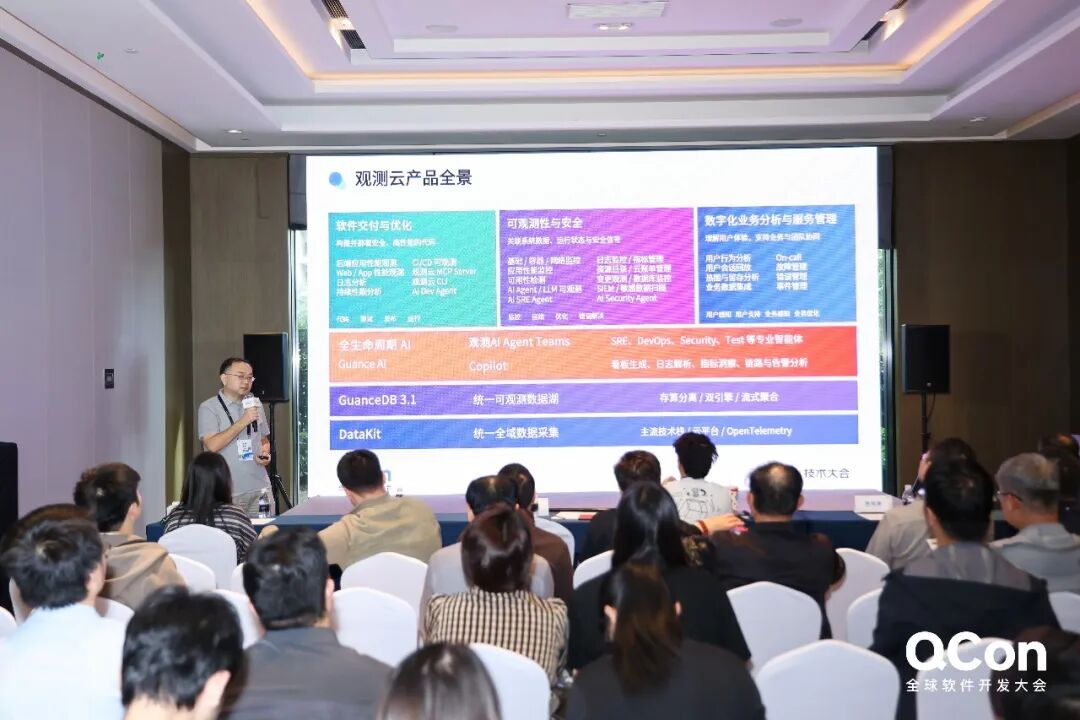
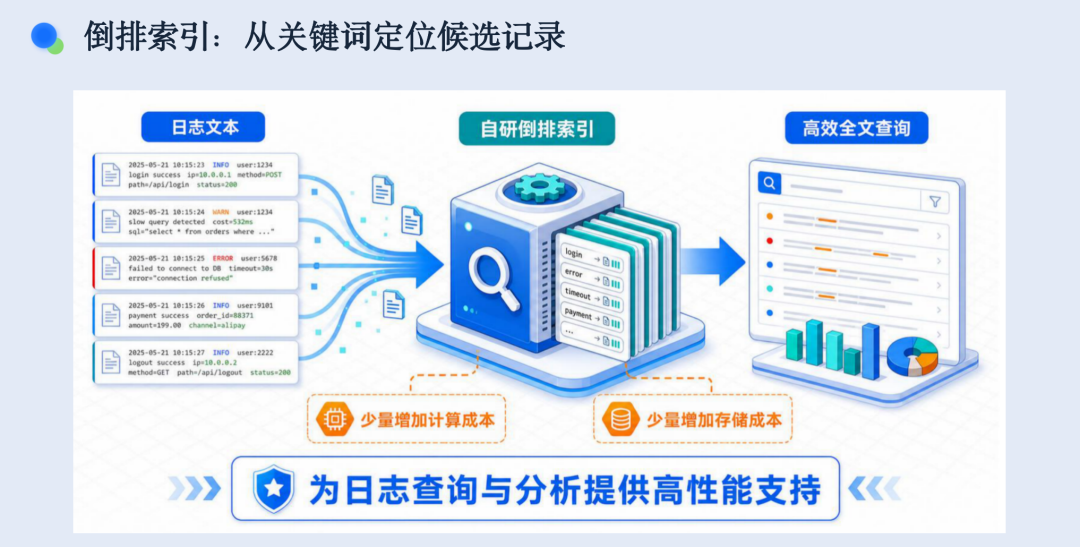
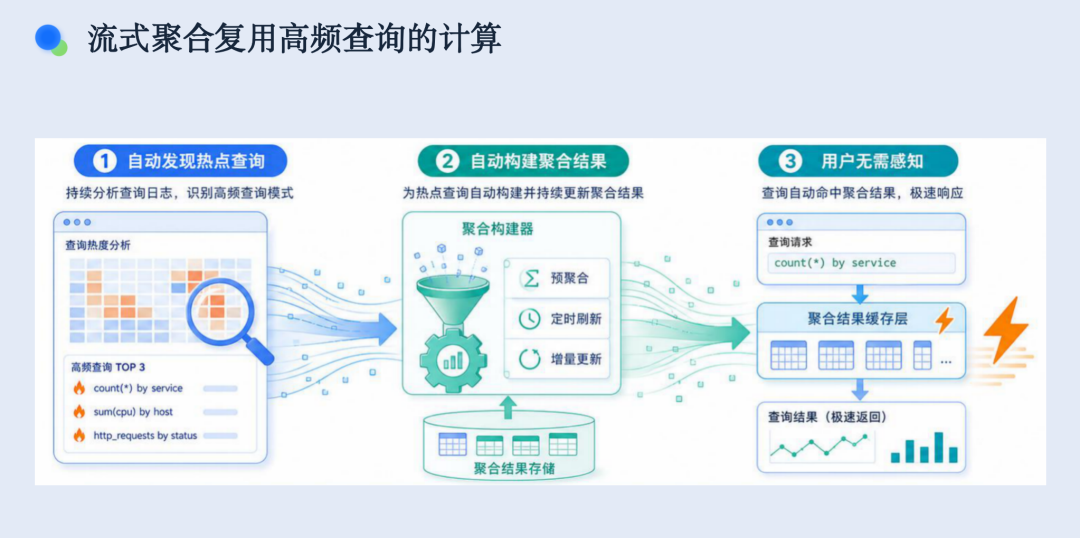
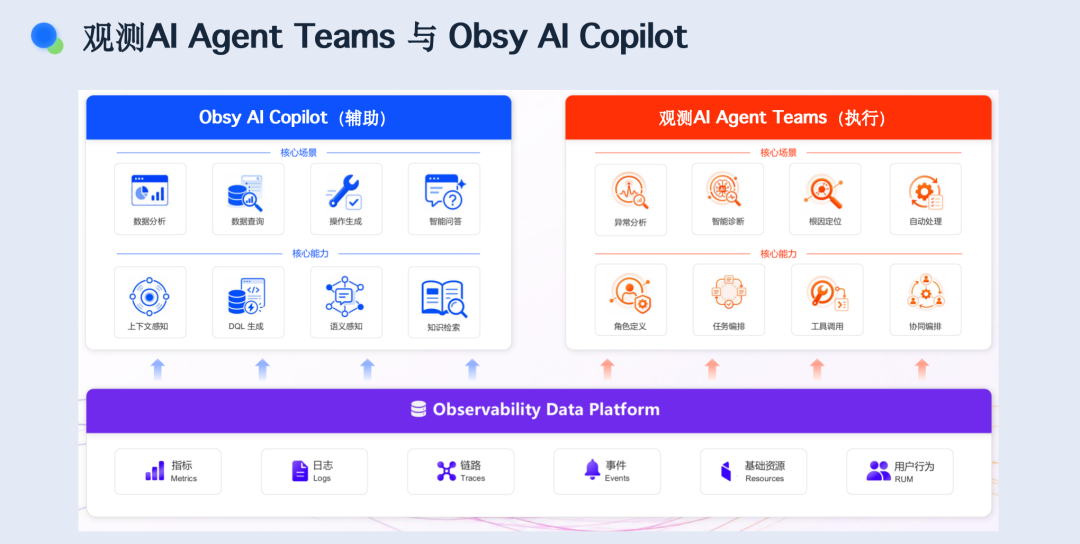
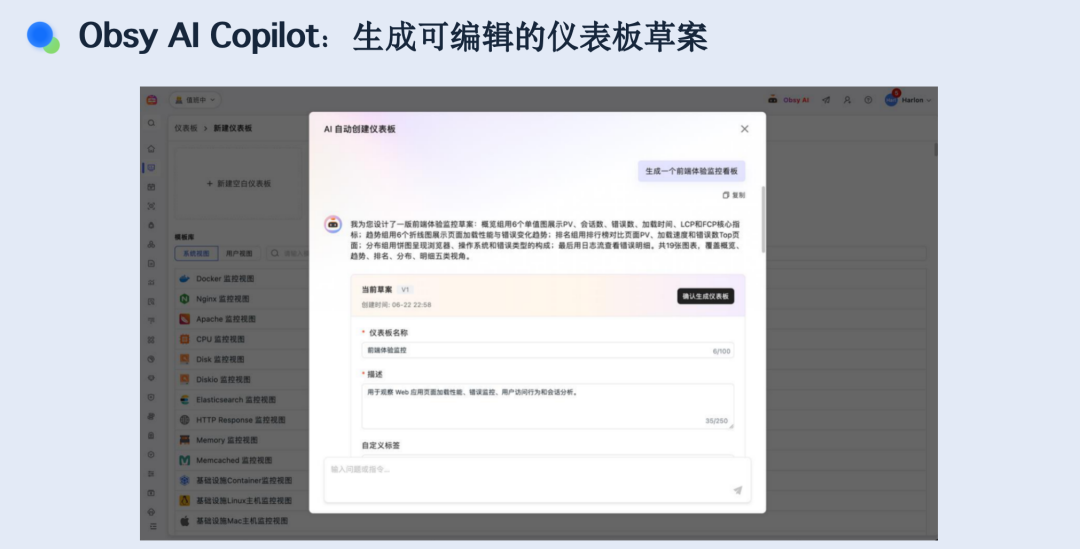
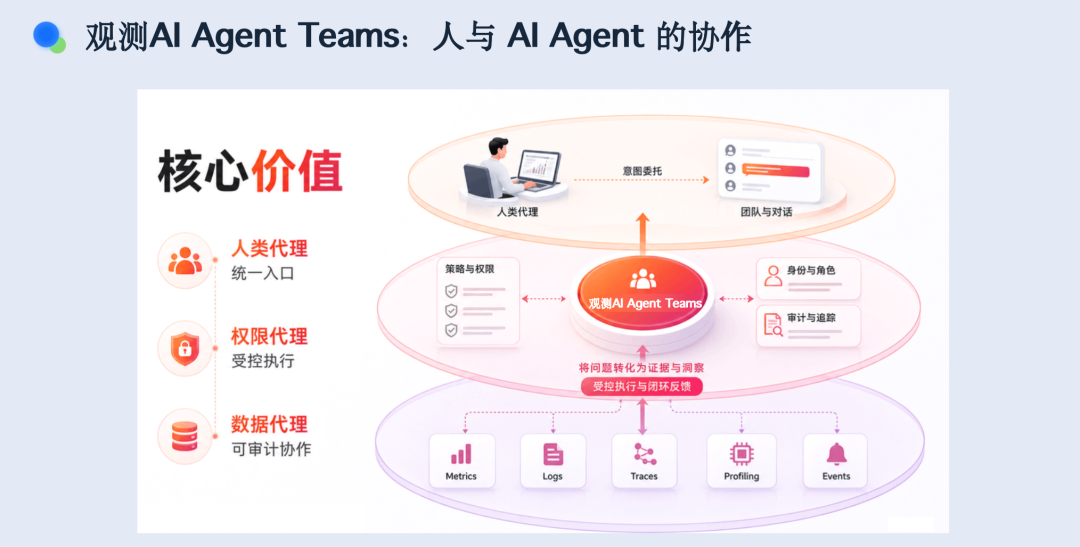
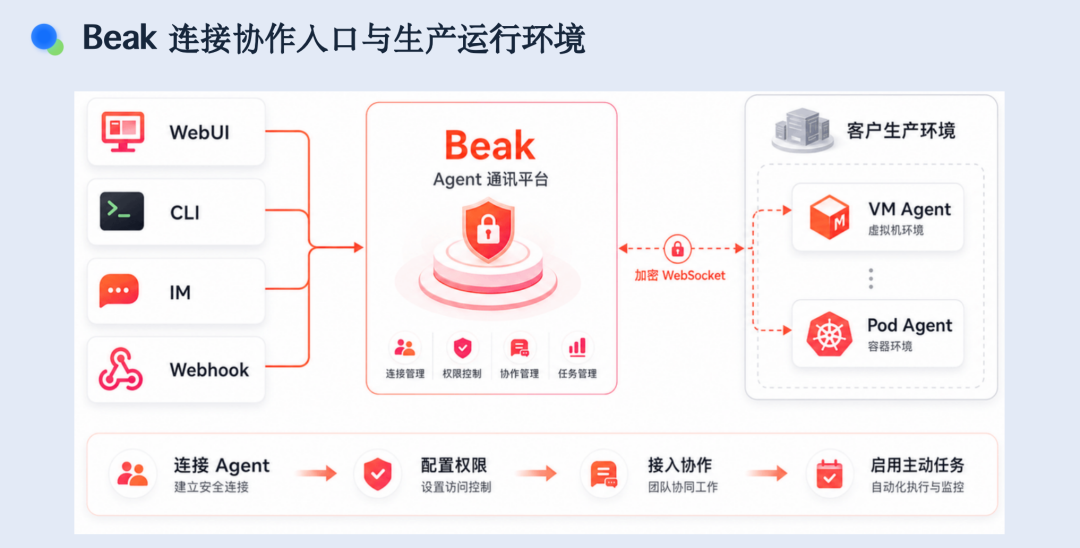
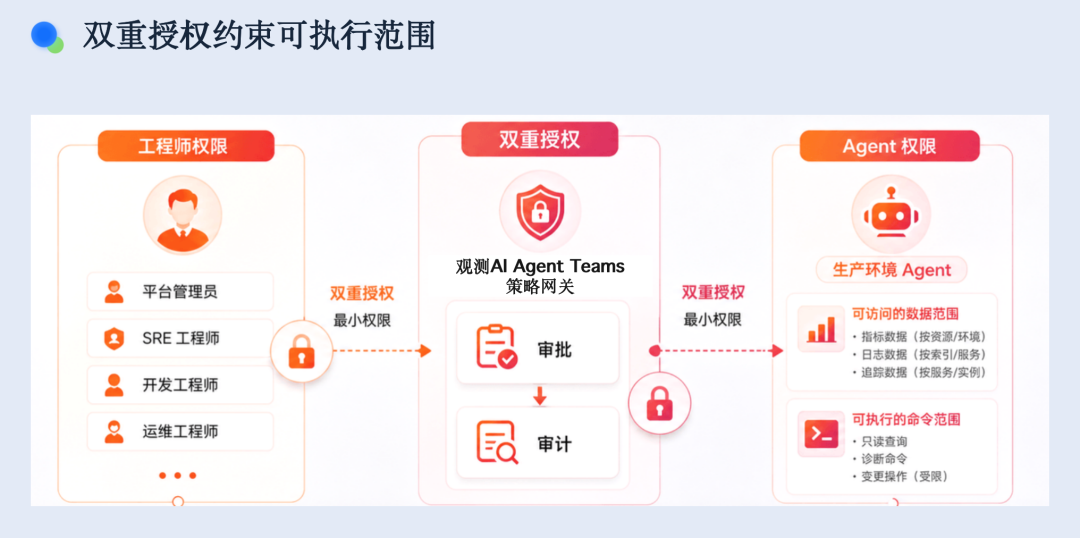
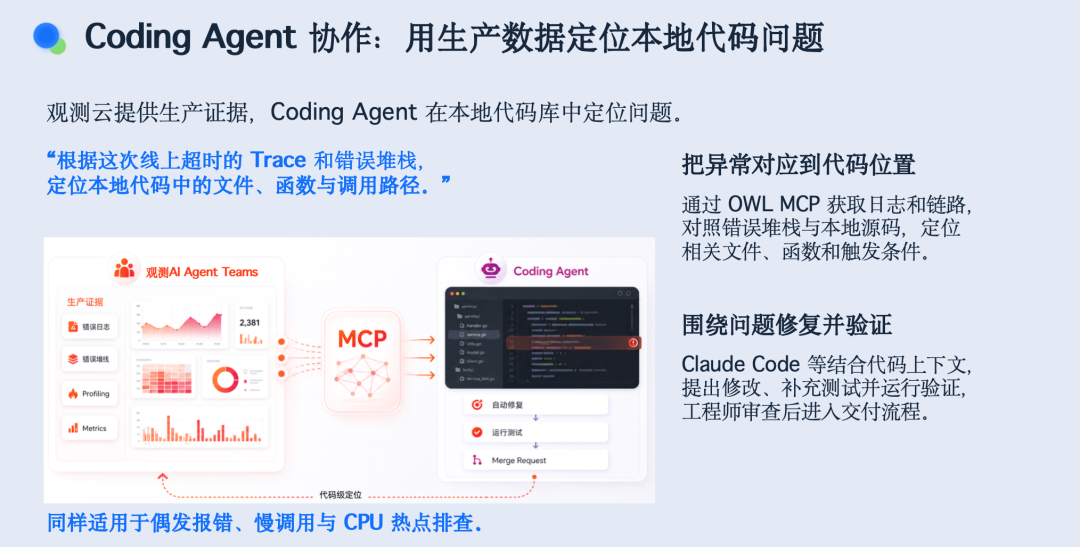
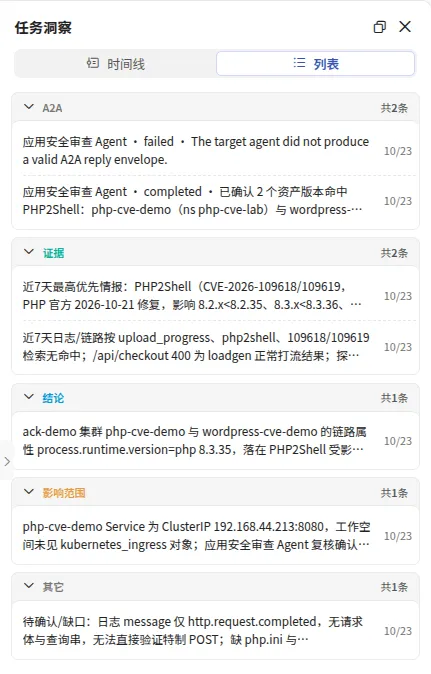
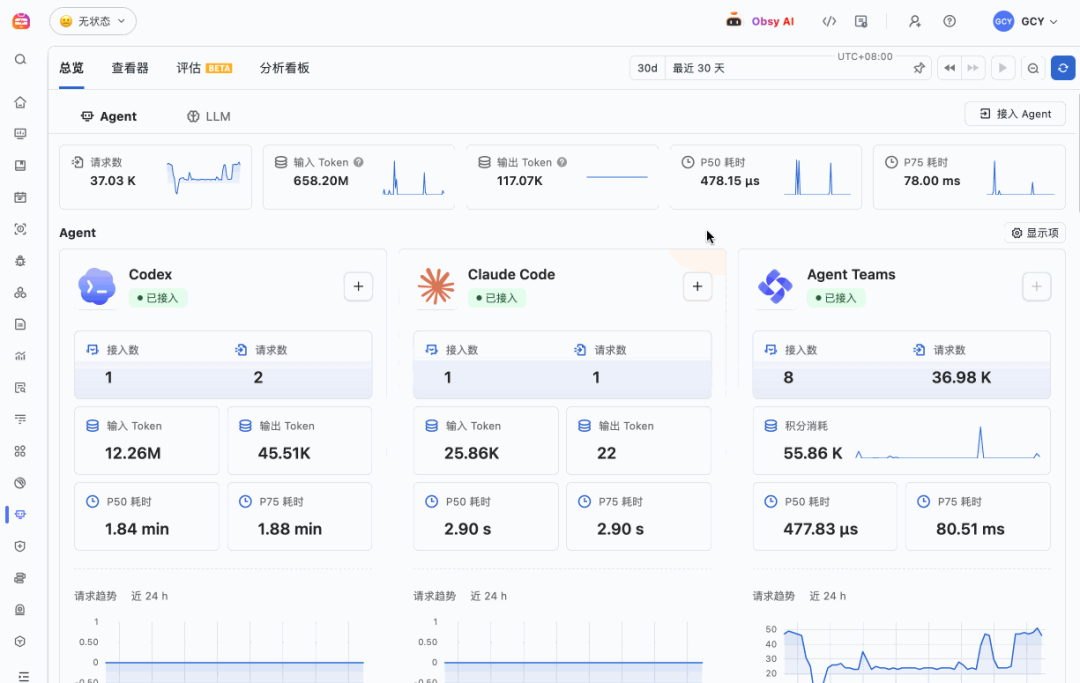
今天借 InfoQ 的机会,和大家完整介绍一下观测云的产品,以及背后的一些核心技术。这也是我们第一次在公开场合集中分享这些实现细节。 简单介绍观测云。我们希望提供一套覆盖全面的可观测产品,在全球市场上主要对标 Datadog。产品覆盖从软件交付,延伸到日志、链路、安全和用户体验。 支撑这些能力的,首先是数据采集。我们的 DataKit 可以从 IT 系统、业务系统和其他设备中实时收集数据,包括工业设备、App、不同编程语言开发的应用,以及网络设备。 数据进来以后,更重要的是把它们关联起来。 传统监控往往比较分散:IT 监控是一套,APM 是一套,日志、用户行为分析和安全又各有一套。回到刚才那个用户报错的例子,工程师需要在不同系统里不断搜索,靠自己掌握的上下文把线索连起来。 观测云把这些信息连接在一个平台里。这样,调查一个问题时,就可以从用户遇到的错误,继续看到相关请求、应用调用和日志。到了 AI 时代,这些关联也成为 Agent 可以使用的上下文。 我们有一家汽车厂客户,遇到过终端 App 崩溃的问题。现象发生在终端,原因却是服务端内存溢出,最终定位到服务端的一行代码。过去,这样的问题可能需要排查好几天。通过 Agent 和平台采集的数据,这个客户在二十多分钟里拿到了指向具体代码的结果。 这个案例也说明,只看终端或者只看服务端,可能都很难把问题看完整。不同环节的数据连接起来,调查才有机会继续往下走。 为了让这些关系更容易组织和使用,我们还提供统一语义层和服务目录。 现在大家经常谈“本体”。在这里,可以把它理解为一种描述实体及其关系的语义层。实体可以是一台服务器,也可以是一家门店、一辆汽车,或者一座电力工厂。我们希望通过这些实体,把不同来源的数据组织到实际业务关系里。 手工维护这些关系也很费力,所以我们支持 Agent 通过 MCP 协助完成这项工作。 从采集、关联到语义组织,目的都是让人和 Agent 在调查时,能够看到同一个问题现场。接下来还有一个要求:这个现场必须足够实时。 为什么 Agent 需要实时的数据底座 传统离线计算和查询,在人的工作流程里有时可以等。但 Agent 分析一个问题,往往需要根据上一次查询的结果,继续决定下一步查什么。如果每一步都要等三十分钟,等一批任务跑完才能拿到数据,调查就很难持续推进。 所以,我们强调实时性。这也是我们所说实现 AIOps 的基础:数据进入平台后,要尽快能够被查询,让 AI 能够持续分析和推进任务。 与此同时,数据规模又非常大。指标、日志、链路一旦积累起来,存储、计算和查询都会带来很高的成本。有些客户希望在一千亿、两千亿条数据中,一两秒就返回结果,同时还要控制成本。 我们找过很多方案,现有方案很难同时满足这些场景要求,最终选择自研数据库。下面介绍几个关键设计。 把写入和查询分开 也让不同查询互不干扰 我们的架构将存储和计算分离,也将读写路径分离。 实时监控对数据延迟很敏感。日志、指标一旦发生延迟或抖动,就可能导致误告警。在读写一体的系统中,查询压力上来以后,会占用 CPU 等资源,写入也可能受到影响。因此,我们把写入和查询拆开,让它们独立运行。 查询之间同样需要隔离。 人发起查询的频率通常比较低,Agent 的查询频率却可能很高,而且难以预测。与此同时,监控告警还需要每隔两分钟、五分钟持续执行。如果这些任务都挤在同一组服务器上,就容易互相影响。 因此,除了读写分离,查询还可以按分区、节点分别执行,让持续运行的监控任务和其他查询能够更好地共存。 用两个引擎承载不同数据 底层有两个核心引擎:指标引擎和事件引擎。 指标引擎主要存储指标数据,支持 Schemaless。用户不必预先设计好所有表结构,上报什么结构,我们就接收什么结构。通过较高的压缩率,并将数据写入对象存储,降低对 SSD 存储的依赖和整体存储成本。为了延续用户已有的使用习惯,我们也兼容 PromQL。 事件引擎主要存储带有时间属性的泛日志数据,包括日志、链路、用户行为和安全事件,同样支持 Schemaless。 事件引擎采用存算分离、读写分离的架构,计算节点无状态。在云上,可以使用按量资源,也可以使用弹性的 Spot 节点,进一步降低计算成本。元数据则使用 PostgreSQL 存储。 这些设计共同服务于一个要求:数据量持续增长时,系统可以扩展,计算资源可以弹性调整,成本也能够控制。 在持续写入中完成处理和数据组织 我们的场景没有时间等一轮离线 ETL。数据进入平台时,就需要完成相应处理,并尽快提供查询。 因此,在写入端,我们提供 Pipeline,通过自己的 DSL 语法处理数据,将其转换成标准 JSON 结构,也可以在这个过程中做实时聚合。 数据的分布方式同样需要适应变化。 做大数据或数据库的同学都知道 Partition By 和 Cluster By 的价值。很多数据库支持类似能力,但往往需要在建表时确定分区和数据组织方式。 在我们的场景里,业务随时变化,写入数据会出现热点和倾斜。系统又不能停下来,重新建表,再把数据搬过去。 所以,我们支持动态调整 Partition By 和 Cluster By。调整过程中,数据可以持续写入,也不需要用户通过重建表、搬迁数据的方式完成变更。 用索引和流式聚合加速查询 数据存下来以后,还需要能快速查出来。 面对千亿级数据,仅靠布隆过滤器或者扫描,很难满足我们的要求。因此,我们构建了全量倒排索引,对字段和全文都建立倒排。 倒排索引本身有成本。在我们的实现和对比场景中,相对于 Elasticsearch 的倒排实现,存储空间下降了接近 70%。这个结果对应的是我们的具体实现和对比条件。 对于经常执行的统计查询,我们还提供自动流式聚合,也可以理解为自动物化视图。 我们不希望用户为查询加速编写大量脚本。系统会针对经常执行的查询,在数据写入时进行聚合计算,减少查询时需要处理的数据量。 举一个说明聚合原理的例子:即使某一秒有一亿条原始数据,如果查询需要的是这一秒的汇总结果,聚合后也可能只是一个数据点。后续再做统计,就不必每次都重新处理全部明细。 这里还要处理迟到数据。比如,五分钟以后才收到属于前面某个时间段的数据,不能因为处理窗口已经过去,就无法更新结果。 我们的实现允许迟到数据回到相应时间的 Bucket,做增量更新,使聚合结果能够继续补充。 统一查询入口 并向外部系统开放 不同类型的数据进入同一个平台以后,我们还希望统一查询方式。因此,我们设计了 DQL,使用自己的 DSL 作为统一查询入口。 在查询执行中,我们会尽量将查询算子、过滤条件,以及 HAVING 子句等下推到存储层,提前进行 I/O 过滤,进一步优化性能。 最近,我们也在准备 FDW 能力。有些 Lakehouse、数据湖场景希望直接读取观测云的数据,我们希望通过外表查询的方式对接,让这些数据能够作为外部表被访问。 从写入处理、数据分布,到索引、聚合和查询,这些工作最终都指向同一个使用场景:当工程师或 Agent 需要了解现场时,能够及时查到相关数据,并继续推进调查。 让 AI 使用数据 也让人能够核对它的判断 有了这样的数据底座,再来看上层的 AI 能力,就比较容易理解了。 我们的 Agent 由自然语言语义驱动。用户可以正常提问,它和 Codex、Claude Code、WorkBuddy 等通用 Agent 一样,智能水平也受所用模型影响。 我们在可观测场景中做的工作,是把平台里的实时数据集和查询能力直接变成 Agent 的工具,让它能够看到相关数据和问题现场。 数据库诊断也是一样。模型需要拿到相关信息,才有条件分析;在这个基础上,模型能力还会影响诊断结果。数据和模型,两方面都很重要。 在产品形态上,我们提供 Obsy AI Copilot 和 AI Agent Teams,它们连接同一个可观测数据平台。 先说更贴近产品界面的 Copilot。 用户看着一个 Dashboard,可以直接问:这个看板说明了什么,刚才发生了什么?Copilot 就可以结合看板和数据协助解释。 有人说,有了 AI 就不需要 BI。我不赞同。AI 可能产生幻觉,人需要有办法验证它的判断。在我们的场景里,看板恰好是一种重要的验证方式。人和 AI 查看同一个 Dashboard、查询同一份数据,才更容易判断分析有没有依据,是否出现误报。 我们也支持通过自然语言生成 Dashboard。 过去设计一个看板,要决定用什么图形、怎样分组、如何布局,工作量不小。现在可以直接提出需求,比如:“根据最近一天的错误订单,构建一个分析看板。”AI 会根据已采集的数据分析 Schema、理解指标含义,再选择合适的图形组织起来。 这样,用户既可以借助 AI 理解数据,也可以通过看板回过头来核对分析结果。 Copilot 主要服务于人在界面中的交互。接下来要介绍的 Teams,则进一步把 Agent 放到持续运行的任务和团队协作中。 让 Agent 持续在线 并连接生产环境 很多人会问,已经有 WorkBuddy、Codex 这样的产品,为什么还要做一个 Agent Runtime? 我们关注的是企业里的具体工作关系。研发、运维各自掌握不同的信息,也承担不同职责。Agent 要参与这些工作,就需要能够连接生产环境、持续接收任务,并与其他 Agent 协作。 因此,我们把 Teams 定位为独立运行、持续在线的后台 Agent。 这里也介绍一下我们的技术选择。Agent Loop、Agent Runtime、工具调用和 Memory 等核心部分,都是我们自己做的。为了满足性能要求,我们也自研了正则相关实现。 除了关键编程语言等基础依赖,我们尽量减少对上游开源软件的依赖。最近集中出现的安全问题,也让我们更加重视这方面的选择。 在运行环境上,Agent 可以部署在客户的虚拟机或 Pod 中,工具也安装在相应环境里。配置相应 MCP 服务后,还可以连接 AWS、阿里云、腾讯云,获取云资源和 Kubernetes 的实时状态。 平台里的指标、日志等数据也可以提供给 Agent 查询。如果分析需要,还可以通过只读方式向它开放部分生产数据库。 为了连接任务入口和这些运行环境,我们构建了 Beak 通信平台。用户可以从飞书、观测云平台发起任务,也可以通过自动化、外部 Webhook 触发,让 Agent 与内部生产环境交互。 能连接环境以后,还需要明确操作边界。 我们在 Agent 上增加了策略网关。遇到危险操作时,Agent 需要向授权人请求确认,没有得到同意,就不能继续执行相应操作。考虑到语义判断可能被绕过,我们也使用确定性的规则限制高风险命令,不完全依赖大模型判断。 有了数据、工具、运行环境和任务入口,Agent 就可以持续承担具体工作。接下来用生产协作和安全分析两个场景,介绍它实际怎么参与。 从生产调查到代码修复 让不同 Agent 接力 先看研发与运维之间的协作。 通常不能允许研发使用的 Coding Agent 直接进入生产环境做变更,但研发要修复问题,又需要知道线上发生了什么。 比如,研发想了解生产 Kubernetes 集群的状态、配置、CPU 使用情况,或者最近有没有故障。过去要请运维去查询,现在可以向一个负责生产调查的 Bot 提问,由它查完后返回结果。 研发再将这些信息交给自己的 Coding Agent,请它分析和修复。这样,生产现场的信息就能够传递到研发环节,同时保留各自的职责和访问边界。 我们支持 A2A 协作,这也是客户使用较多的一种方式。 例如,研发可以在 WorkBuddy 或 Codex 中设置定时任务,每小时向生产 Agent 询问一次:“线上有没有故障?”生产 Agent 收集现场信息,整理成详细报告,再返回给研发 Agent。 研发 Agent 能访问源代码,就可以依据报告定位代码缺陷,完成修改,形成 PR,并通知工程师 Review。工程师看到的,是线上出现了什么问题、修改针对什么原因,以及需要审核的代码。 我们内部也较广泛地使用这种方式。开发同学保持 Agent 运行,收到 PR 后审核,再决定是否合入后续版本。已有 Bug、故障和性能问题,都可以结合线上用户的真实行为来发现,并推动修复。 当然,不同团队会选择不同的参与程度。 在实际使用中,用户也会直接问:“最近有没有订单故障?”“工厂有没有异常?”Agent 根据收集到的数据进行调查分析。具备相应工具时,它可以参与修复;目前很多客户更倾向于先让 AI 给出建议,发送到飞书群或其他通知对象,再由人来处理。 从调查建议到协作修复,团队可以根据实际需要,决定让 Agent 承担哪一段工作。而在安全场景中,这种持续调查的能力尤其有价值。 把漏洞检查和入侵线索分析变成持续任务 安全问题既涉及系统有没有已知漏洞,也涉及异常行为发生以后,能不能及时发现。Agent 可以围绕这两个方向,持续使用情报、环境信息和运行数据开展分析。 根据最新漏洞情报检查自身系统 我们在产品中提供了 AI 监控器,可以通过自然语言表达持续执行的任务。 传统监控通常需要先配置规则,比如 CPU 大于 90% 时告警。这类规则比较容易写,但要判断一个系统是否受到新披露漏洞的影响,就很难仅靠一组固定阈值完成。 现在,用户可以提出这样的任务:“每个小时检查一下系统的运行状态,同时同步互联网上最新的 CVE 报告,帮助判断我们的应用系统是否存在相关安全风险。” Agent 按这个目标开展检查,发现风险后告警。这就是我们所说的 AI 语义监控:用户可以直接表达需要持续关注的问题。 结合环境和工具开展蓝军检查 进一步看,Agent 已经部署在相应的虚拟机或 Pod 中,也可以获得平台数据和云资源状态。在授权范围内,为它安装安全检查、攻防相关工具,就可以让它承担团队的蓝军检查任务,检查自己的系统。 安装不同工具,Agent 可以承担不同角色。结合指标、日志、云资源和 Kubernetes 的实时状态,它也能获得更完整的检查上下文。 这里的重点是,让持续运行的 Agent 围绕实际环境开展工作。它需要知道正在检查什么系统、能够使用哪些工具,以及哪些操作需要进一步确认。 从大量日志中追查不容易察觉的行为 另一个重要方向,是从已经发生的访问和操作中寻找可疑线索。 攻击者可能通过 API 进入系统,访问 Web 页面,或者执行某些操作。如果相应环节有完整采集,这些活动就可能在 API 日志、访问日志和执行记录中留下线索。 困难在于,收集到日志以后,人也很难事先写出一条规则,直接判断“这就是黑客登录”。入侵方式很多,有些行为要跨多个步骤关联起来,单独看一条记录并不明显。 有了关联的观测数据和 Agent,就可以用自然语言描述需要调查的可疑行为,列出关注的情形,让它持续分析,发现异常后告警,再进一步核实。 我们内部就遇到过一个例子。凌晨三点,系统提示有人登录核心系统,群里的同事立即开始核查。后来确认,是运维同学临时有事需要处理,并不是黑客入侵。 这个案例说明的是,对不寻常访问行为进行持续分析,能够让团队及时介入核查。异常告警本身还需要结合现场判断。如果访问来自攻击者,同样需要有机会尽早发现。 面对几千万行 Access Log,人很难逐条看完,也很难持续串联所有行为。AI 可以协助承担这部分分析工作。 最近一些企业安全事件中,攻击者曾声称自己在系统里潜伏了很长时间,没有被发现。这类说法需要核实,但它提醒我们关注一个实际问题:即使系统存在漏洞,异常访问和操作发生以后,我们有没有足够的数据和监控策略去发现它? 很难承诺一个企业完全没有漏洞。持续检查新的漏洞风险,同时保留并分析访问记录,能让团队在风险暴露和异常发生时,有依据继续调查、安排处理。 前面介绍的生产调查与研发协作,也说明了后续工作的衔接方式:调查需要形成能够被工程师使用的信息,再根据问题性质决定由谁处理、如何修复。不同场景的任务可以继续衔接,但具体处置仍要依据现场证据。 当 Agent 开始工作 也要看见它自己的行为 前面一直在讲,如何让 Agent 使用观测数据。最后再看另一个方向:Agent 自身也会产生运行数据,也需要被观测。 过去,我们扩展过 Apple TV、Vision Pro 等场景的可观测能力。今年的重要主题是 Agent,因此我们也提供 AI Agent Observability。 除了 LangChain、Langfuse、Dify 等框架或应用相关的观测场景,我们还支持桌面 Agent 的观测,并提供了 AgentMeter 这样的接入工具。 企业可以采集员工使用 Codex、Claude Code、WorkBuddy、OpenClaw 等应用时产生的 Token 消耗、工具调用和调用关系。无论是基于框架开发的 Agent,还是桌面应用,都可以纳入观测,查看不同应用的使用情况和会话关系。 在观测云官网的“关于我们”页面,我们还公开展示了团队的实时 Token 消耗。数据来自内部接入的 Agent 观测,可以看到每天的使用情况。 这些行为数据采集以后,也可以继续交给前面介绍的 Agent 能力分析。 例如,每小时检查用户调用这些 Agent 的行为是否存在风险,发现风险就通知相关人员,进一步检查越权、逃逸等风险迹象。这样,Agent 的行为采集就能与持续分析衔接起来。 回到今天最开始那个用户报错的场景,我们希望做的,是让分散的数据能够被关联,让调查时需要的信息能够及时被查询,再让 Agent 基于这些信息参与分析、协作和处理。 这也是为什么今天要把数据采集、数据库、Copilot、Teams 和 Agent 观测放在一起讲。它们连接的是同一条工作过程:看见现场,理解问题,再把事情向前推进。 今天的分享就到这里,谢谢大家。