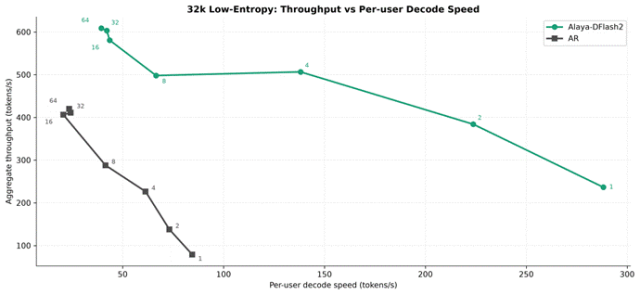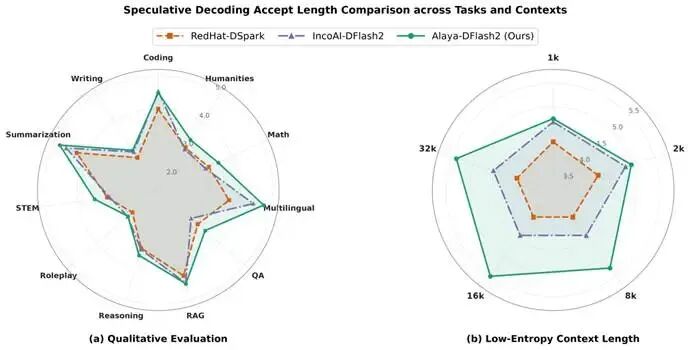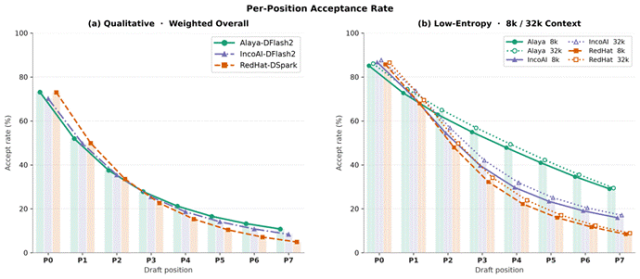
近日,九章云极 DataCanvas 推出自研推测解码加速方案 Alaya-DFlash2,针对智谱 AI 旗舰大模型 GLM-5.3 完成深度适配优化,有效解决长上下文场景下自回归解码时延高、生成速度慢的行业痛点。实测显示,在 8×H200、TP=8 硬件配置下,GLM-5.3 单并发解码速度最高可达 288.2 tokens/s,较原生自回归解码方案提升 3.41 倍,在 1 至 64 并发全档位下,同步实现单用户生成速度与整体服务吞吐双重提升,为长文档分析、代码工程、智能体复杂任务等高价值场景落地扫清性能障碍机器之心。 随着大模型向百万级超长上下文演进,传统自回归解码的短板日益凸显:模型每生成一个 token,都需要重复读取并计算全部历史上下文,上下文越长,生成延迟越高,严重影响用户交互体验与业务服务能力。GLM-5.3 作为新一代旗舰基座,具备 1M 上下文窗口、强大代码能力与深度推理能力,在项目级文档处理、软件工程、复杂智能体任务中具备广阔应用空间,但长文本解码效率一直是规模化部署的核心瓶颈。 Alaya-DFlash2 是九章云极面向长上下文场景打造的推测解码技术方案,核心由并行草稿模型与智能路径选择机制构成。该方案通过轻量化草稿模型并行预生成多步候选 token 序列,再由主模型 GLM-5.3 批量完成校验验证,一次性通过符合预期的候选片段,改变传统逐 token 串行生成模式,大幅削减长上下文重复计算开销;同时依托自研路径选择策略,保障长上下文环境下草稿候选的高接受率,在提速的同时守住模型输出质量,兼顾速度、一致性与稳定性。 本次评测覆盖单并发至 64 并发多档位负载,测试结果验证了方案的通用性:不同于部分加速方案仅能优化低并发场景、高并发下性能反转的问题,Alaya-DFlash2 在全部测试并发规格中,性能均优于原生自回归解码,整体吞吐最高提升约 3 倍,兼顾个人开发者低并发交互与企业侧高并发业务服务两类需求,适配知识库问答、合同解析、代码工程开发、长报告撰写等典型长文本业务。 作为国家专精特新重点 “小巨人” 企业,九章云极长期深耕 AI 基础设施领域,依托九章智算云 Alaya NeW Cloud 底座,持续围绕大模型推理、调度、缓存、推测解码等方向持续迭代底层优化技术,先后推出多项面向主流基座模型的推理加速能力,持续打通国产大模型从能力到落地的性能链路,降低企业部署长上下文大模型的算力成本与时延门槛。 九章云极表示,Alaya-DFlash2 将持续迭代优化,进一步拓展适配更多主流大模型基座,同时深度集成至九章智算云服务体系,让开发者与企业用户开箱即用、无需复杂改造即可享受长文本推理加速红利。未来,公司将持续聚焦大模型训推一体化技术创新,持续完善国产智算生态,推动长上下文大模型、AI 智能体在千行百业规模化落地,助力新质生产力发展。