


2026 年 9 月 22 日,北京—— 小米正式发布并开源新一代原生全模态大模型 MiMo-V2.6 系列,包含 MiMo-V2.6-Pro、MiMo-V2.6-Flash 两款模型,并同步推出 MiMo-V2.6-Pro-UltraSpeed 高速版本。全系原生支持文本、图像、视频、音频多模态输入,面向复杂推理、智能体(Agent)协作、大型软件工程、网络安全等专业场景深度优化,同步开放模型权重、技术报告、强化学习训练框架与任务环境,向全球开发者社区释放完整 AI 技术能力。
MiMo-V2.6 系列是小米探索递归自我改进(RSI)技术路线的里程碑成果。项目团队规模化拓展强化学习算力,完成近 6 天不间断公开 RL 训练,累计生成 75 万条训练轨迹,大幅提升模型在真实复杂任务中的解决能力。其中旗舰版本 MiMo-V2.6-Pro 为万亿参数稀疏 MoE 架构,激活参数约 420 亿,上下文窗口可达 100 万 token;高效版本 MiMo-V2.6-Flash 采用 3090 亿参数 MoE 混合注意力架构,激活参数 150 亿,同样支持百万级长上下文,兼顾推理能力与部署成本。UltraSpeed 版本在保持 Pro 模型原生智能水平的前提下,输出速度最高提升 20 倍,适配强实时交互场景需求。
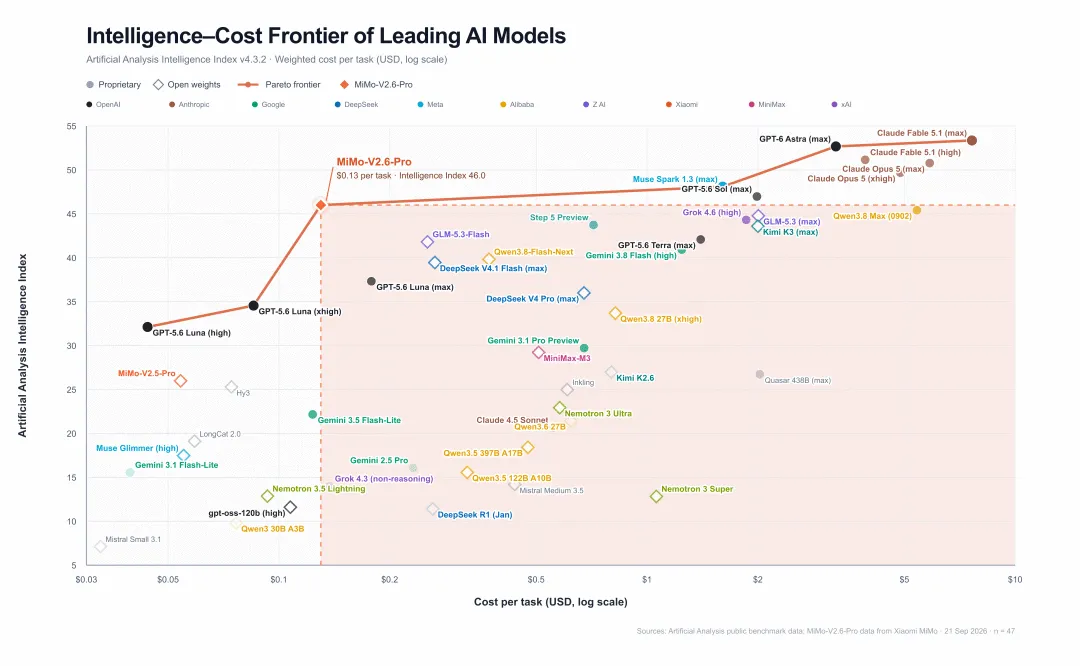
在权威评测榜单 Artificial Analysis 中,MiMo-V2.6-Pro 综合智能指数取得 46 分,超越 Qwen 3.8 Max、GLM 5.3 Max、Kimi K3 Max,登顶开源模型与国产模型榜首。在软件工程、漏洞复现、网页开发等智能体任务评测中,模型性能较 SFT 基线获得显著提升:SWE-bench Verified 从 61.1 提升至 66.2,MiMo Cyber Bench 由 31.3 提升至 47.0,Terminal Bench 2.1 提升至 52.8,MiMo Visual Coding 达到 72.4 分,充分验证模型在代码工程、安全攻防、视觉编程等硬核场景的落地能力。
本次开源并非仅开放模型权重,小米同步向社区释放整套可复现的强化学习体系:包含 7000 + 高质量 RL 任务环境、端到端 RL 训练框架、轻量可组合 Agent 运行 Harness,以及 MiMo-V2.6-Distill-Qwen-9B 蒸馏模型与全套 RL 研究资源。开发者可基于开源套件,自主开展强化学习算法、奖励机制、智能体框架的研究迭代,降低前沿 Agent 技术的研究门槛,推动全模态智能体生态共建。
在商用服务层面,MiMo-V2.6 系列延续 V2.5 定价体系,模型能力升级但 API 价格保持不变。Flash 版本每百万词元输入 1 元、输出 2 元;Pro 版本每百万词元输入 3 元、输出 6 元,并提供最高 99% 缓存折扣。在同等智能水平下,其调用成本仅为海外同类模型的 1/20 至 1/60,为企业开发者提供高性价比的全模态 AI 服务底座,助力多模态大模型产业化落地。
小米 MiMo 团队表示,MiMo-V2.6 坚持开源开放理念,希望通过公开完整训练过程、模型权重与训练工具链,和全球科研人员、开发者共同探索大模型递归自我改进的技术路径。未来团队将持续迭代 MiMo 系列模型,持续打通基础大模型、智能体框架与终端应用,推动全模态 AI 技术在办公、开发、智能硬件等场景落地。
MiMo-V2.6 系列模型权重、技术文档、开源套件已在 MiMo 官网开放获取,API 服务同步上线小米 MiMo 开放平台,开发者可前往官网查阅完整技术报告、评测数据与部署指南。
