


新智元报道

当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
社交媒体为这一问题提供了具体场景。
Agent需要理解创作者的定位,协调多种工具完成内容制作,并在发布之后面对真实受众的反馈。一次任务中的选题判断、表达方式与执行结果,都可能影响下一次决策。
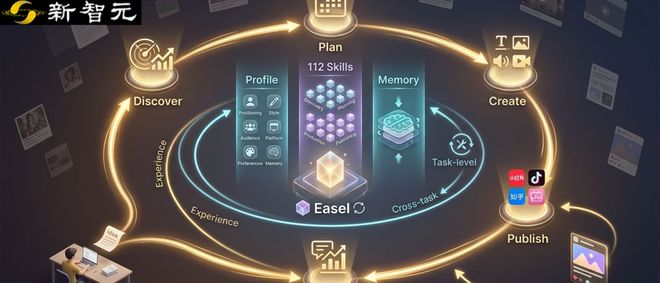
浙江大学REAL Lab与北京大学OpenDCAI Lab联合开源的Easel,正围绕这一过程展开探索。项目将账号画像、多模态技能、平台交互与反馈分析连接起来,构建覆盖发现、策划、制作、发布和复盘的连续工作流。
项目主页:zju-real.github.io/Easel
代码链接:github.com/ZJU-REAL/Easel
Easel 的研究切入点,是将内容创作组织为一个能够积累上下文与经验的交互过程:Agent 在任务中执行,在结果中发现问题,再将值得保留的经验带入后续任务。当前,这种持续适应主要通过外部记忆与上下文更新实现,为探索 Self-Evolving 的社媒Agents提供具体的系统基础。
真实社交媒体:一个具有长期约束的交互环境
社交媒体内容生产包含连续的决策依赖。选题影响脚本,脚本影响素材制作,平台表达影响受众理解,发布后的互动又为后续创作提供反馈。一次生成的质量,只能反映其中一个局部环节。
这个环境还具有三个值得研究的特征。
首先,目标具有个性化。同一个话题,对不同账号的价值不同;同一篇论文,面向专业读者和普通受众时,需要采用不同的解释路径。
其次,环境持续变化。热点、受众兴趣与平台条件并不固定,过去有效的方法需要在新的任务中重新判断其适用性。
最后,反馈具有延迟和噪声。内容表现受到选题、表达、曝光和时机等因素共同影响,Agent 需要区分可以复用的经验与偶然结果。
这些特征使持续创作成为研究长期 Agent 的一个具体入口:系统既要保持对用户目标的稳定理解,也要根据新的证据调整行动。
画像与长期记忆:持续适应如何发生
Easel 将账号上下文组织为定位、风格、受众、平台、偏好边界和长期记忆六个维度,让用户约束能够贯穿不同任务。
例如,一个科技账号反复强调「保留方法细节,但减少术语堆砌」,这一偏好可以影响后续选题深度、脚本结构和图文表达。Agent在新任务中读取相关上下文,无需每次重新建立对账号的理解。
长期记忆则承接交互中形成的新经验。Agent会筛选可复用的偏好、制作方法与效果发现,经用户确认后增量写入,并与已有内容合并。临时规格和一次性参数不会直接成为长期规则。
由此,Easel 形成了一条基于记忆的适应路径:任务交互产生反馈,反馈被提炼为候选经验,经确认后进入长期上下文,再参与后续决策。
这里变化的是Agent可使用的知识与经验。用户确认使记忆更新具有可审视性,也为纠正错误总结保留了入口。围绕这一机制,可以进一步研究经验的筛选、保留与更新,以及长期积累是否真正改善了后续任务表现。
112个skills:多模态任务编排与执行经验复用
持续适应需要落实到具体行动。Easel 当前内置 112 个 Skills,覆盖发现、策划、制作、发布、归因及基础能力,将执行流程、领域知识和工具调用方式组织为可组合的能力单元。
Agent 根据任务目标选择技能,按需读取流程与参考资料,再协调文字、图像、语音和视频工具执行。复杂任务被拆解为具有依赖关系的步骤,各步骤共享上游结果。
以论文解读为例,Agent 先提炼研究问题、方法与关键证据,再组织文章、知识卡片或视频脚本,随后完成配图、配音、字幕与合成。同一组结构化材料支撑不同表达,减少各模态独立理解原文带来的信息偏移。
Easel 按项目保存源文件、中间产物与最终成品,并记录关键结论、产物关系和执行状态。后续步骤能够复用已有素材与决策,失败时也可以根据记录定位问题、继续处理。
从研究角度看,这使任务经验拥有了具体载体:成功的结构、有效的素材组织方式和执行中的问题,都有机会被回顾和复用。开放的技能体系也允许开发者将验证过的方法沉淀为流程,为进一步研究技能选择与组合策略提供基础。
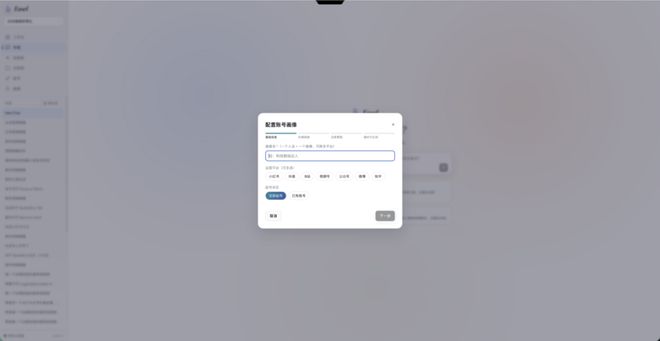
账号画像·为不同账号建立可复用的创作上下文
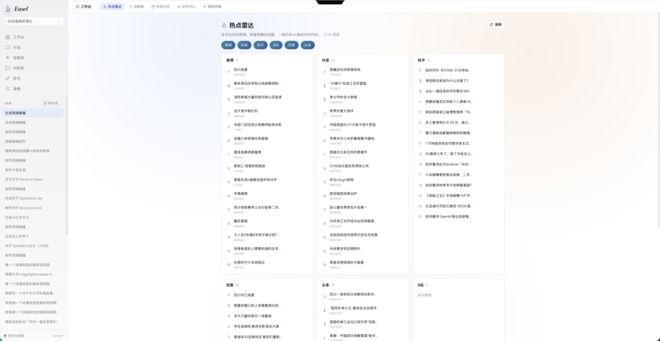
热点雷达·聚合多平台趋势筛,选适合当前账号的选题
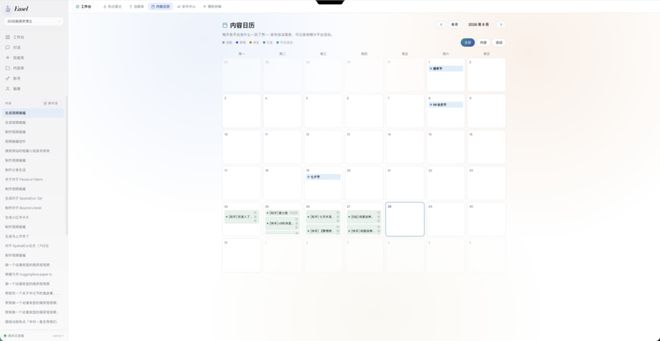
内容日历·统一管理选题、草稿、待发和已发内容
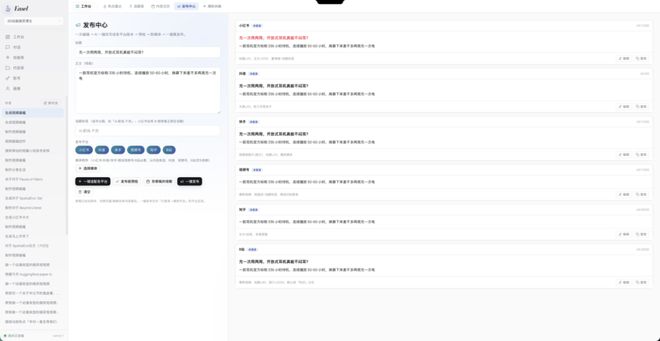
发布中心·从一份母版生成多平台版本并完成发布检查
两种反馈:任务内修复与跨任务适应
Easel 中的反馈可以从两个时间尺度理解。
任务内反馈直接作用于当前产物。模型负责内容理解、结构设计与表达判断,工具负责媒体处理和规格检查,再根据结果指导修改。例如,图文需要检查布局与可读性,视频需要核对画面、声音和字幕;生成对白存在偏差时,可以根据检查结果选择替换配音或重新生成。
这种局部反馈帮助 Agent 在当前任务中发现错误,并将修复动作作用于相关环节。
跨任务反馈则来自用户修订和发布后的表现。哪些解释反复造成理解障碍,哪些制作方法被用户持续认可,哪些选题值得继续展开,都可能形成后续任务的参考。
两种反馈承担不同职责:前者支持当前任务完成,后者为长期行为调整提供依据。将它们连接起来,才能进一步研究局部修正如何转化为可迁移的经验,以及相似错误是否会在后续任务中减少。
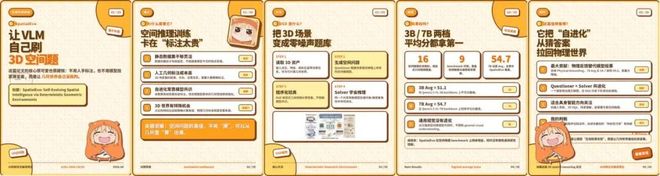
SpatialEvo·论文解读
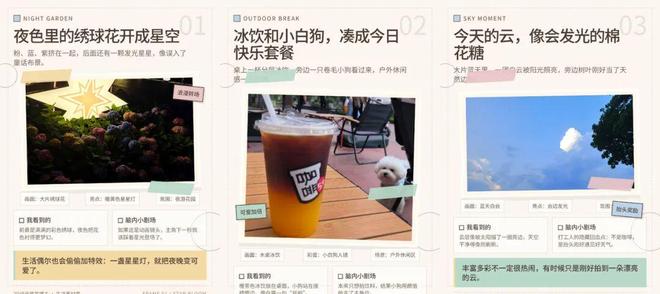
生活记录
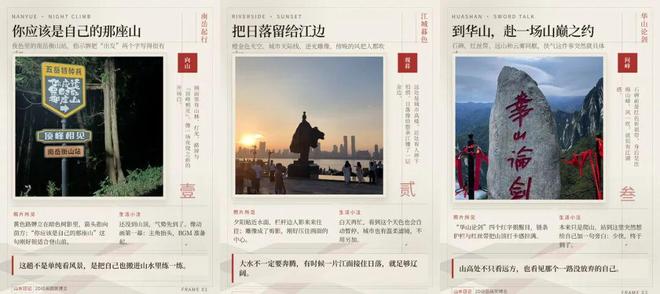
自然风光
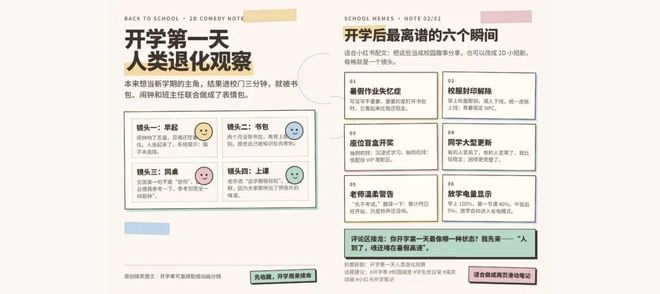
梗词卡片
跨平台表达:检验经验的适用边界
同一内容进入小红书、抖音、知乎和B站时,需要调整信息密度、叙事节奏与媒体形式。Easel 支持围绕共同材料生成不同平台版本,并进行发布前检查。
这一场景也提供了观察经验迁移的机会。某种解释结构可能适合多个平台,某种开场方式却可能只在特定受众中有效。Agent 需要保持核心信息一致,同时根据新的条件调整表达。
因此,跨平台任务能够提出更具体的研究问题:哪些经验属于账号的稳定偏好,哪些依赖平台和内容形式?从一个场景中总结的方法,迁移到另一个场景后是否仍然有效?
Easel 通过画像、项目材料和平台上下文共同组织这些任务,为比较不同条件下的行为与结果提供了基础。
从真实反馈中学习:经验质量比记忆数量更重要
发布之后,Easel将内容事件与账号时序数据纳入分析。工具完成指标统计与趋势计算,Agent结合账号上下文解释结果,并提出调整建议。
但高互动并不能直接证明某种策略有效。热点时机、额外曝光和样本差异,都可能影响结果。如果把偶然表现固化为长期规则,记忆反而可能使后续判断产生偏差。
因此,Easel的分析流程要求保留样本量与数据覆盖情况,并区分相关关系和因果关系。可复用的发现再经过创作者确认,进入账号画像。
这也意味着,对自进化能力的评估不能只看系统保存了多少经验,还需要检验:经验是否有依据,是否适用于新任务,是否减少了用户纠正,以及在环境变化后能否被合理修订。
面向自进化社媒Agent的开放研究
浙江大学REAL Lab与北京大学OpenDCAI Lab希望通过Easel,探索Agent在真实社交媒体中的理解与行动能力:它如何同时理解创作者的定位和受众的需求?如何协调多模态工具完成连续任务?又如何从带有噪声的真实反馈中提炼有效经验?
Easel开放了技能体系、画像结构、执行工具与架构文档,将用户上下文、多模态任务执行和真实反馈连接到同一套可观察的工作流中。
创作者可以通过实际任务提供交互与反馈,开发者可以扩展模型、工具和技能,研究者则能够围绕具体机制开展对比实验:长期记忆是否改善个性化一致性,结构化中间产物是否减少信息偏移,执行检查是否降低重复错误,以及历史经验能否帮助Agent应对新的任务条件。
这些问题也构成了 Easel 后续探索自进化的方向。当前系统提供了经验积累与反馈利用的基础,而更可靠的经验筛选、适用条件建模和技能改进,仍需要进一步研究与验证。
从完成一次任务,到让一次任务的经验改善下一次行动,是Easel希望持续探索的核心问题。真实社交媒体中的长期交互,为检验这一过程提供了具体而复杂的环境。
